para orientarte
Sale un modelo nuevo y en cuestión de horas aparecen demos que parecen hacer el trabajo de una persona completa. Para decidir si probarlo, elegí una tarea que vos realmente tenés que aprobar el lunes y evaluá si la mejora.
Vamos a bajar Astra del titular a un caso de trabajo medible.
Primero, una corrección pequeña que evita una confusión grande: el nombre es GPT 6 Astra, no Astro.
OpenAI presentó Astra el 3 de septiembre de 2026. Al 6 de septiembre, el lanzamiento sigue siendo gradual. OpenAI dice que empezó con un conjunto limitado de organizaciones y que ampliará el acceso a usuarios elegibles de ChatGPT y a sus canales de API y cloud.
La respuesta corta: Astra está diseñado menos como “un chat que sabe más cosas” y más como un modelo capaz de sostener trabajo complejo de principio a fin: investigación, programación, uso de computadora, navegación y creación de documentos. La mejora importante es la combinación de capacidades en tareas largas. Eso no significa que ya sea infalible ni que podamos declarar AGI.
Modelo y producto: dos cosas distintas
GPT 6 Astra es un modelo. ChatGPT es el producto.
Dentro de ChatGPT, un modelo puede trabajar con archivos, memoria, web, plugins, Work o Codex según tu plan y la superficie disponible.
Si cambiás Astra por otro modelo, no necesariamente cambian todos esos permisos o herramientas. Por eso cuando una demo parece “el modelo hizo X”, preguntá qué parte vino del modelo y qué parte vino del entorno.
La explicación completa está en Fundamentos de IA.
Qué anunció OpenAI
OpenAI describe Astra como su modelo más capaz hasta ahora para:
- coding y software engineering;
- browsing y research;
- computer use (operar una interfaz visual mediante herramientas);
- ciencia y trabajo profesional;
- tareas complejas con muchos pasos;
- creación de documentos, spreadsheets y presentaciones siguiendo instrucciones y plantillas.
Esa última parte importa. La frontera se está moviendo desde “generar una buena respuesta” hacia “mantener el objetivo, operar herramientas y entregar algo terminado”.
El cambio que más importa: computer use
Un modelo con computer use (uso de computadora) puede interpretar una interfaz y ejecutar acciones en ella cuando el producto le da acceso.
Eso abre tareas como:
- abrir un panel;
- buscar información;
- descargar un archivo;
- compararlo con otra fuente;
- llenar una hoja;
- crear una presentación;
- detenerse para pedir aprobación antes de enviar.
La mejora no elimina el riesgo. De hecho, cuanto mejor puede operar una computadora, más importante se vuelve limitar qué puede cambiar.
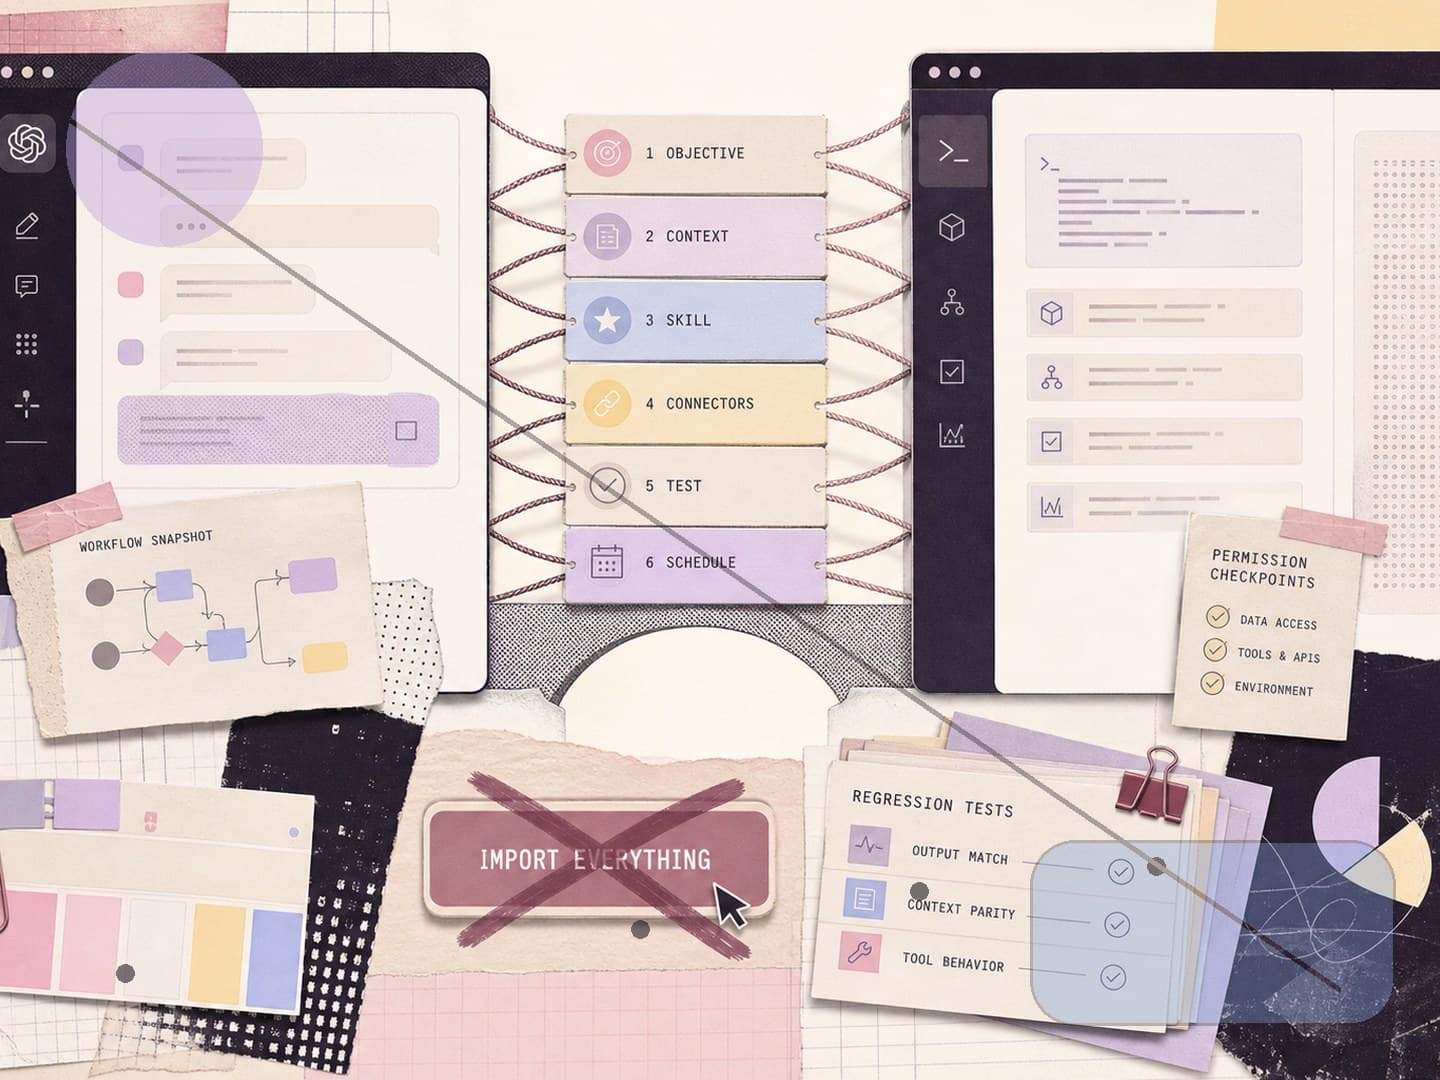
Usá una escala de permisos:
| Permiso | Ejemplo | Regla inicial |
|---|---|---|
| Lectura | abrir archivos, buscar datos | permitir cuando la fuente es necesaria |
| Reversible | crear un borrador | permitir con registro |
| Externo | enviar, publicar, comprar | exigir aprobación |
| Destructivo | borrar, revocar, transferir | bloquear salvo proceso controlado |
Astra no está disponible para todo el mundo al mismo tiempo
Este punto es importante porque las capturas de otras personas pueden hacerte creer que tu cuenta está rota.
En sus notas de lanzamiento del 3 de septiembre, OpenAI dijo que Astra comenzó con acceso limitado y que la disponibilidad más amplia llegaría gradualmente. La superficie también importa: Chat, Work, Codex y API pueden tener fechas o requisitos distintos.
Si no aparece en tu selector, no significa que configuraste algo mal. Revisá las notas oficiales del producto y tu plan.
El benchmark que necesita contexto: ARC AGI 3
OpenAI destaca un 99.9% en ARC AGI 3. El número es real bajo una configuración específica, pero necesita contexto para no convertirlo en una conclusión incorrecta.
ARC Prize reportó dos resultados muy diferentes:
- 62.7% con su Standard harness (configuración estándar de prueba), una interfaz común para comparar proveedores;
- 99.9% con un Provider Adapter que conserva estado de razonamiento opaco entre solicitudes y usa compaction para conversaciones largas.
Ambos resultados son impresionantes. Pero no responden exactamente a la misma pregunta.
ARC Prize dice explícitamente que saturar ARC AGI 3 no prueba que un sistema haya alcanzado AGI. El benchmark ayuda a medir aprendizaje y adaptación en entornos nuevos, no toda la inteligencia humana ni toda la autonomía real.
Esta es una buena lección para cualquier ranking: siempre preguntá qué se midió, con qué herramientas y bajo qué condiciones.
Un salto que también aumenta el riesgo
OpenAI clasifica a Astra en nivel Critical para capacidad de ciberseguridad dentro de su Preparedness Framework. Según su safety overview, con herramientas y acceso adecuados puede encontrar vulnerabilidades desconocidas y desarrollar rutas de explotación más avanzadas que generaciones anteriores.
La versión de acceso público tiene límites. La capacidad base exige salvaguardas más fuertes, monitoreo y restricciones de acceso.
OpenAI también dice que Astra incluye monitoreo adicional para detectar posibles interpretaciones incorrectas de instrucciones en tareas de agentes. Una conversación puede pausarse para revisión.
Para usuarias comunes, la enseñanza es más amplia: un agente más competente merece mejores límites, no menos.
Tres ejemplos que muestran el cambio
1. Investigación que termina en un entregable
Antes: “resumí estos diez artículos”.
Ahora el flujo puede ser:
“Investigá las fuentes oficiales, construí una matriz con fecha, claim y evidencia, marcá contradicciones, luego creá un memo de dos páginas y una presentación de seis slides. No uses una afirmación sin fuente.”
La calidad sigue dependiendo de las fuentes y la revisión.
2. Operaciones
“Revisá los tickets de esta semana y el documento de SLA. Clasificá incumplimientos, citá evidencia y prepará un plan de corrección. No cambies tickets ni envíes mensajes.”
El valor está en cruzar sistemas y sostener el objetivo, no en escribir un párrafo bonito.
3. Programación
“Reproducí este bug, encontrá la causa, proponé el cambio mínimo, ejecutá tests y explicá el riesgo antes de modificar producción.”
Un modelo más fuerte puede reducir iteraciones, pero branch, tests y code review siguen existiendo por una razón.
Cuándo NO elegir Astra
No usés el modelo más pesado por reflejo.
Para una traducción corta, clasificar una lista o reescribir un email, un modelo más rápido y barato puede ser suficiente. Astra tiene más sentido cuando el costo de razonamiento adicional compra algo que podés medir: menos errores, menos iteraciones o una tarea completa que otros modelos no terminan bien.
Probá el mismo set de 10 casos con dos modelos y compará:
- exactitud;
- tiempo;
- costo;
- correcciones humanas;
- cumplimiento de formato;
- tasa de finalización.
¿Astra es AGI?
No existe una prueba universal que permita responder sí solamente porque un modelo domina un benchmark.
Astra muestra un progreso extraordinario en generalización, computer use y tareas de varios pasos. Al mismo tiempo, evaluaciones del ecosistema siguen mostrando una frontera irregular: sistemas de frontera pueden dominar matemáticas avanzadas y todavía fallar en tareas que una persona encuentra triviales.
Por eso nuestra respuesta al 6 de septiembre es: Astra nos acerca a algunas definiciones operativas de AGI, pero no resuelve el desacuerdo sobre qué cuenta como AGI ni demuestra competencia general robusta en el mundo real.
Leé el análisis completo en ¿Qué es AGI y qué tan cerca estamos?.
Para ubicar estas capacidades dentro del sistema completo, leé Fundamentos de IA y qué es un agente.
Qué haría esta semana
- No cambiaría todos mis workflows por un lanzamiento de tres días.
- Elegiría dos tareas difíciles donde mi modelo actual falla.
- Probaría Astra cuando mi cuenta tenga acceso.
- Mantendría exactamente los mismos inputs y criterios.
- Compararía costo por resultado aprobado.
- Revisaría permisos antes de habilitar computer use o acciones externas.
Para aprovechar el cambio, identificá qué trabajo ahora podés resolver de una forma que antes no era viable.
Fuentes
- OpenAI: GPT 6 Astra
- OpenAI: Release notes
- OpenAI: Safety overview for GPT 6 Astra
- ARC Prize: GPT 6 Astra on ARC AGI 3
Revisión editorial: actualizada y verificada el 6 de septiembre de 2026.
Pasá de leer a hacer
Probalo esta semana
La habilidad que te llevás: Delegar trabajo de varios pasos sin soltar la revisión humana
Tu prueba, paso a paso
Elegí una tarea que termine en un entregable real y que hoy requiera varias pestañas, archivos o pasos.
Definí fuentes permitidas, formato final, criterios de calidad y acciones que necesitan tu aprobación.
Pedí un plan corto antes de la ejecución y corregí cualquier supuesto incorrecto.
Revisá fuentes, números y acciones externas antes de aprobar el resultado.
Ideas, recursos y límites para hacerlo bien
Dónde usarlo
Empezá donde ya hay fricción
En tu trabajo
- Preparar un memo de research con fuentes.
- Cruzar documentos y una hoja de cálculo para producir un reporte.
- Preparar una presentación o plan de proyecto a partir de evidencia dispersa.
También en tu día a día
- Organizar una investigación de viaje o mudanza sin mezclar recomendaciones con hechos.
- Preparar una comparación de servicios o compras grandes con criterios definidos por vos.
Para profundizar
- OpenAI Academy: Get started with ChatGPT WorkGuía para distinguir una pregunta rápida de un trabajo completo.
- OpenAI Academy: Reimagine GuideAyuda a elegir, probar y medir un workflow antes de escalarlo.
Cuándo pedir otra mirada
- La tarea permite enviar mensajes, mover dinero, publicar o borrar información.
- La herramienta pide permisos que no entendés.
- No podés revisar el resultado con una fuente independiente.
Tu siguiente movimientoGuardá el caso y repetilo con el mismo criterio para crear tu benchmark personal.
Transparencia editorial
Este artículo fue investigado y preparado con ayuda de IA. Nina revisó fuentes, contexto, criterio editorial y versión final.